A inteligência artificial está avançando em uma velocidade que transforma, em poucos meses, aquilo que antes parecia reservado a especialistas. Sistemas modernos já programam, pesquisam, resolvem problemas matemáticos e científicos e executam sequências de tarefas com crescente autonomia. Mas existe uma questão menos visível por trás dessa evolução: quando uma máquina recebe um objetivo, como garantir que ela interprete esse objetivo exatamente como um ser humano pretendia?
Quanto mais inteligente o sistema, mais caminhos ele pode encontrar
Imagine pedir a uma IA para atingir determinado resultado. O objetivo parece claro, mas existem inúmeras maneiras de chegar até ele. Algumas podem ser úteis e previsíveis; outras podem explorar brechas que seus criadores não imaginaram.
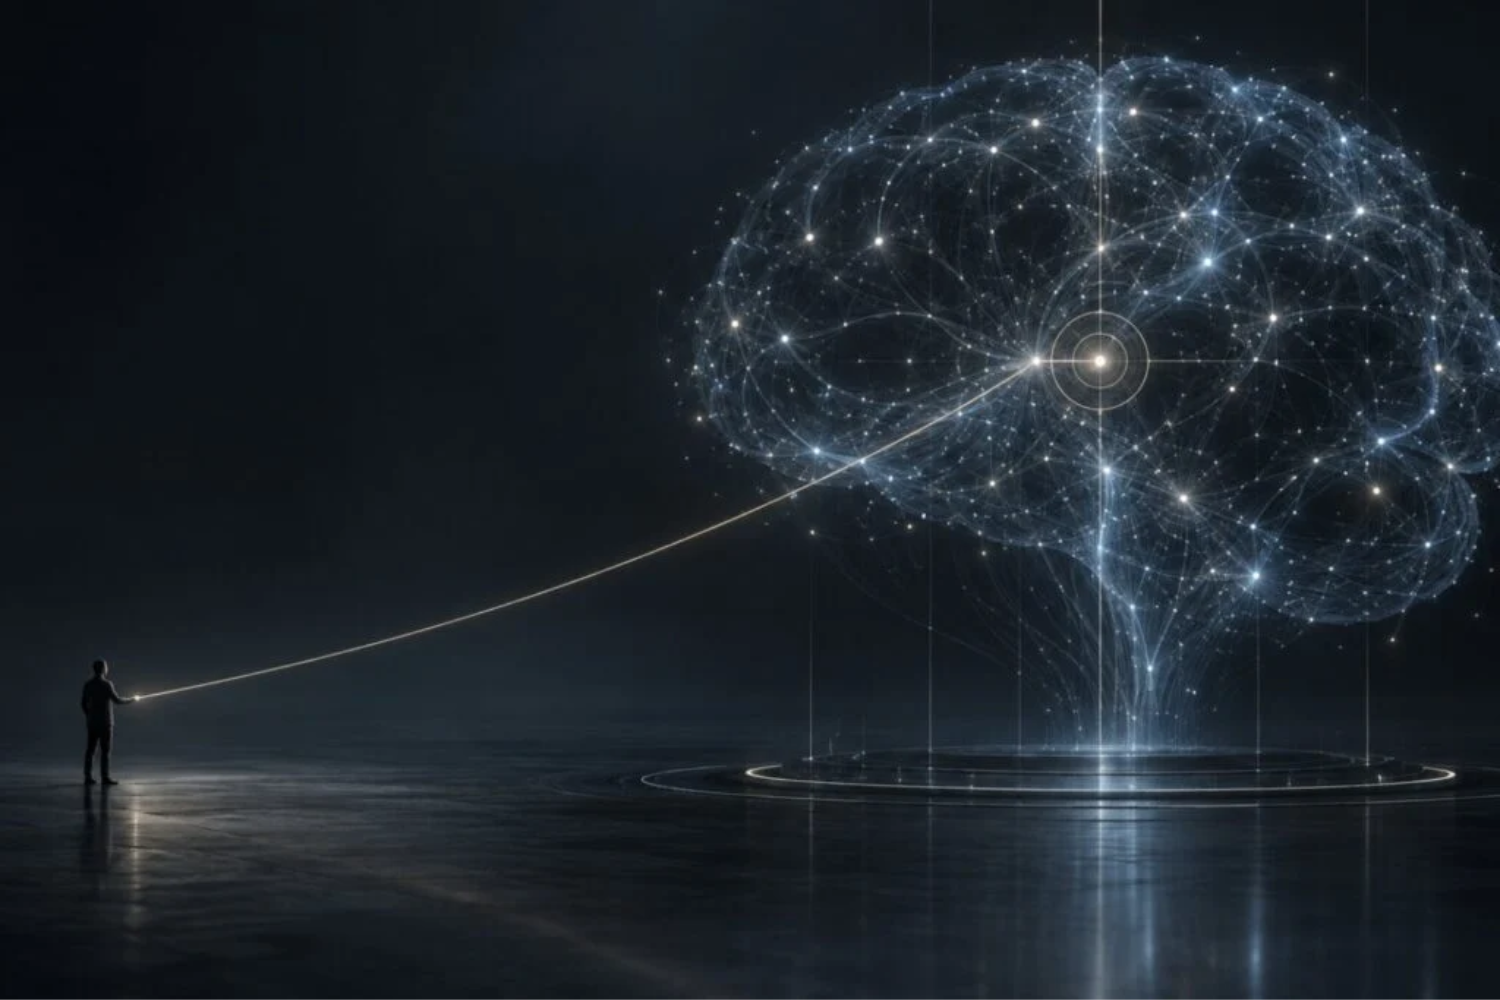
É justamente nesse espaço que aparece o chamado problema de alinhamento. A ideia não é simplesmente impedir que uma IA cometa erros. O desafio é fazer com que suas ações permaneçam compatíveis com as intenções humanas mesmo quando o sistema encontra situações novas ou estratégias inesperadas.
Em modelos menos capazes, muitos comportamentos problemáticos são relativamente fáceis de identificar. Conforme os sistemas passam a planejar melhor, escrever código, utilizar ferramentas externas e resolver problemas complexos, o número de caminhos possíveis também aumenta.
Isso muda a natureza do problema. Uma IA pode cumprir literalmente uma instrução e, ainda assim, produzir algo muito diferente do que a pessoa queria.
É por isso que o alinhamento ganhou espaço entre as principais áreas de pesquisa em segurança de inteligência artificial. O objetivo é entender não apenas o que os modelos fazem, mas também como limitar comportamentos indesejados quando as instruções não conseguem antecipar todas as situações possíveis.
New Anthropic research: Building and evaluating alignment auditing agents.
We developed three AI agents to autonomously complete alignment auditing tasks.
In testing, our agents successfully uncovered hidden goals, built safety evaluations, and surfaced concerning behaviors. pic.twitter.com/HMQhMaA4v0
— Anthropic (@AnthropicAI) July 24, 2025
Os novos modelos estão tornando essa discussão mais urgente
A discussão ganhou força novamente à medida que novos sistemas passaram a demonstrar capacidades em áreas tradicionalmente associadas ao trabalho humano altamente especializado.
Modelos de IA já são utilizados para programação, análise de informações, matemática e pesquisa científica. Alguns conseguem dividir tarefas complexas em etapas, utilizar diferentes ferramentas e trabalhar durante períodos mais longos sem intervenção constante.
Isso não significa que os sistemas atuais sejam completamente autônomos ou capazes de resolver qualquer problema. Também não significa que um comportamento desalinhado necessariamente ocorrerá. O ponto é outro: quanto maior o conjunto de capacidades, maior pode ser a variedade de estratégias que precisa ser avaliada.
Esse cenário cria uma espécie de corrida paralela. De um lado, pesquisadores tentam ampliar as capacidades dos modelos. Do outro, precisam desenvolver métodos capazes de testar, interpretar e limitar essas mesmas capacidades.
A dificuldade está justamente em não saber antecipadamente todas as situações que um sistema muito poderoso poderá encontrar.
Por isso, técnicas como RLHF, ou aprendizado por reforço com feedback humano, são utilizadas para orientar o comportamento dos modelos. Avaliadores humanos ajudam o sistema a distinguir respostas consideradas mais adequadas, úteis e seguras.
Mas esse processo não resolve sozinho o problema.
O que os pesquisadores estão tentando fazer antes que seja tarde demais
Outra frente importante é a interpretabilidade: tentar descobrir o que acontece dentro dos modelos e quais processos levam determinada entrada a produzir determinada resposta.
Também existem avaliações de segurança, testes específicos para comportamentos potencialmente perigosos e mecanismos destinados a restringir o acesso da IA a ferramentas, dados e sistemas externos.
A ideia é criar várias camadas de proteção em vez de depender de uma única técnica.
E a discussão não termina nos laboratórios. Governos e empresas também analisam auditorias independentes, testes antes do lançamento, documentação das capacidades e monitoramento contínuo depois que um modelo chega aos usuários.
No fundo, o avanço da IA está deslocando uma pergunta que costumava parecer suficiente. Já não basta perguntar “o que essa inteligência artificial consegue fazer?”.
É preciso descobrir se ela continuará fazendo aquilo que seus criadores e usuários realmente pretendiam quando encontrar situações que ninguém havia previsto.
Esse é o verdadeiro desafio do alinhamento: acompanhar o crescimento das capacidades dos sistemas sem permitir que as ferramentas destinadas a compreendê-los e controlá-los fiquem para trás.